
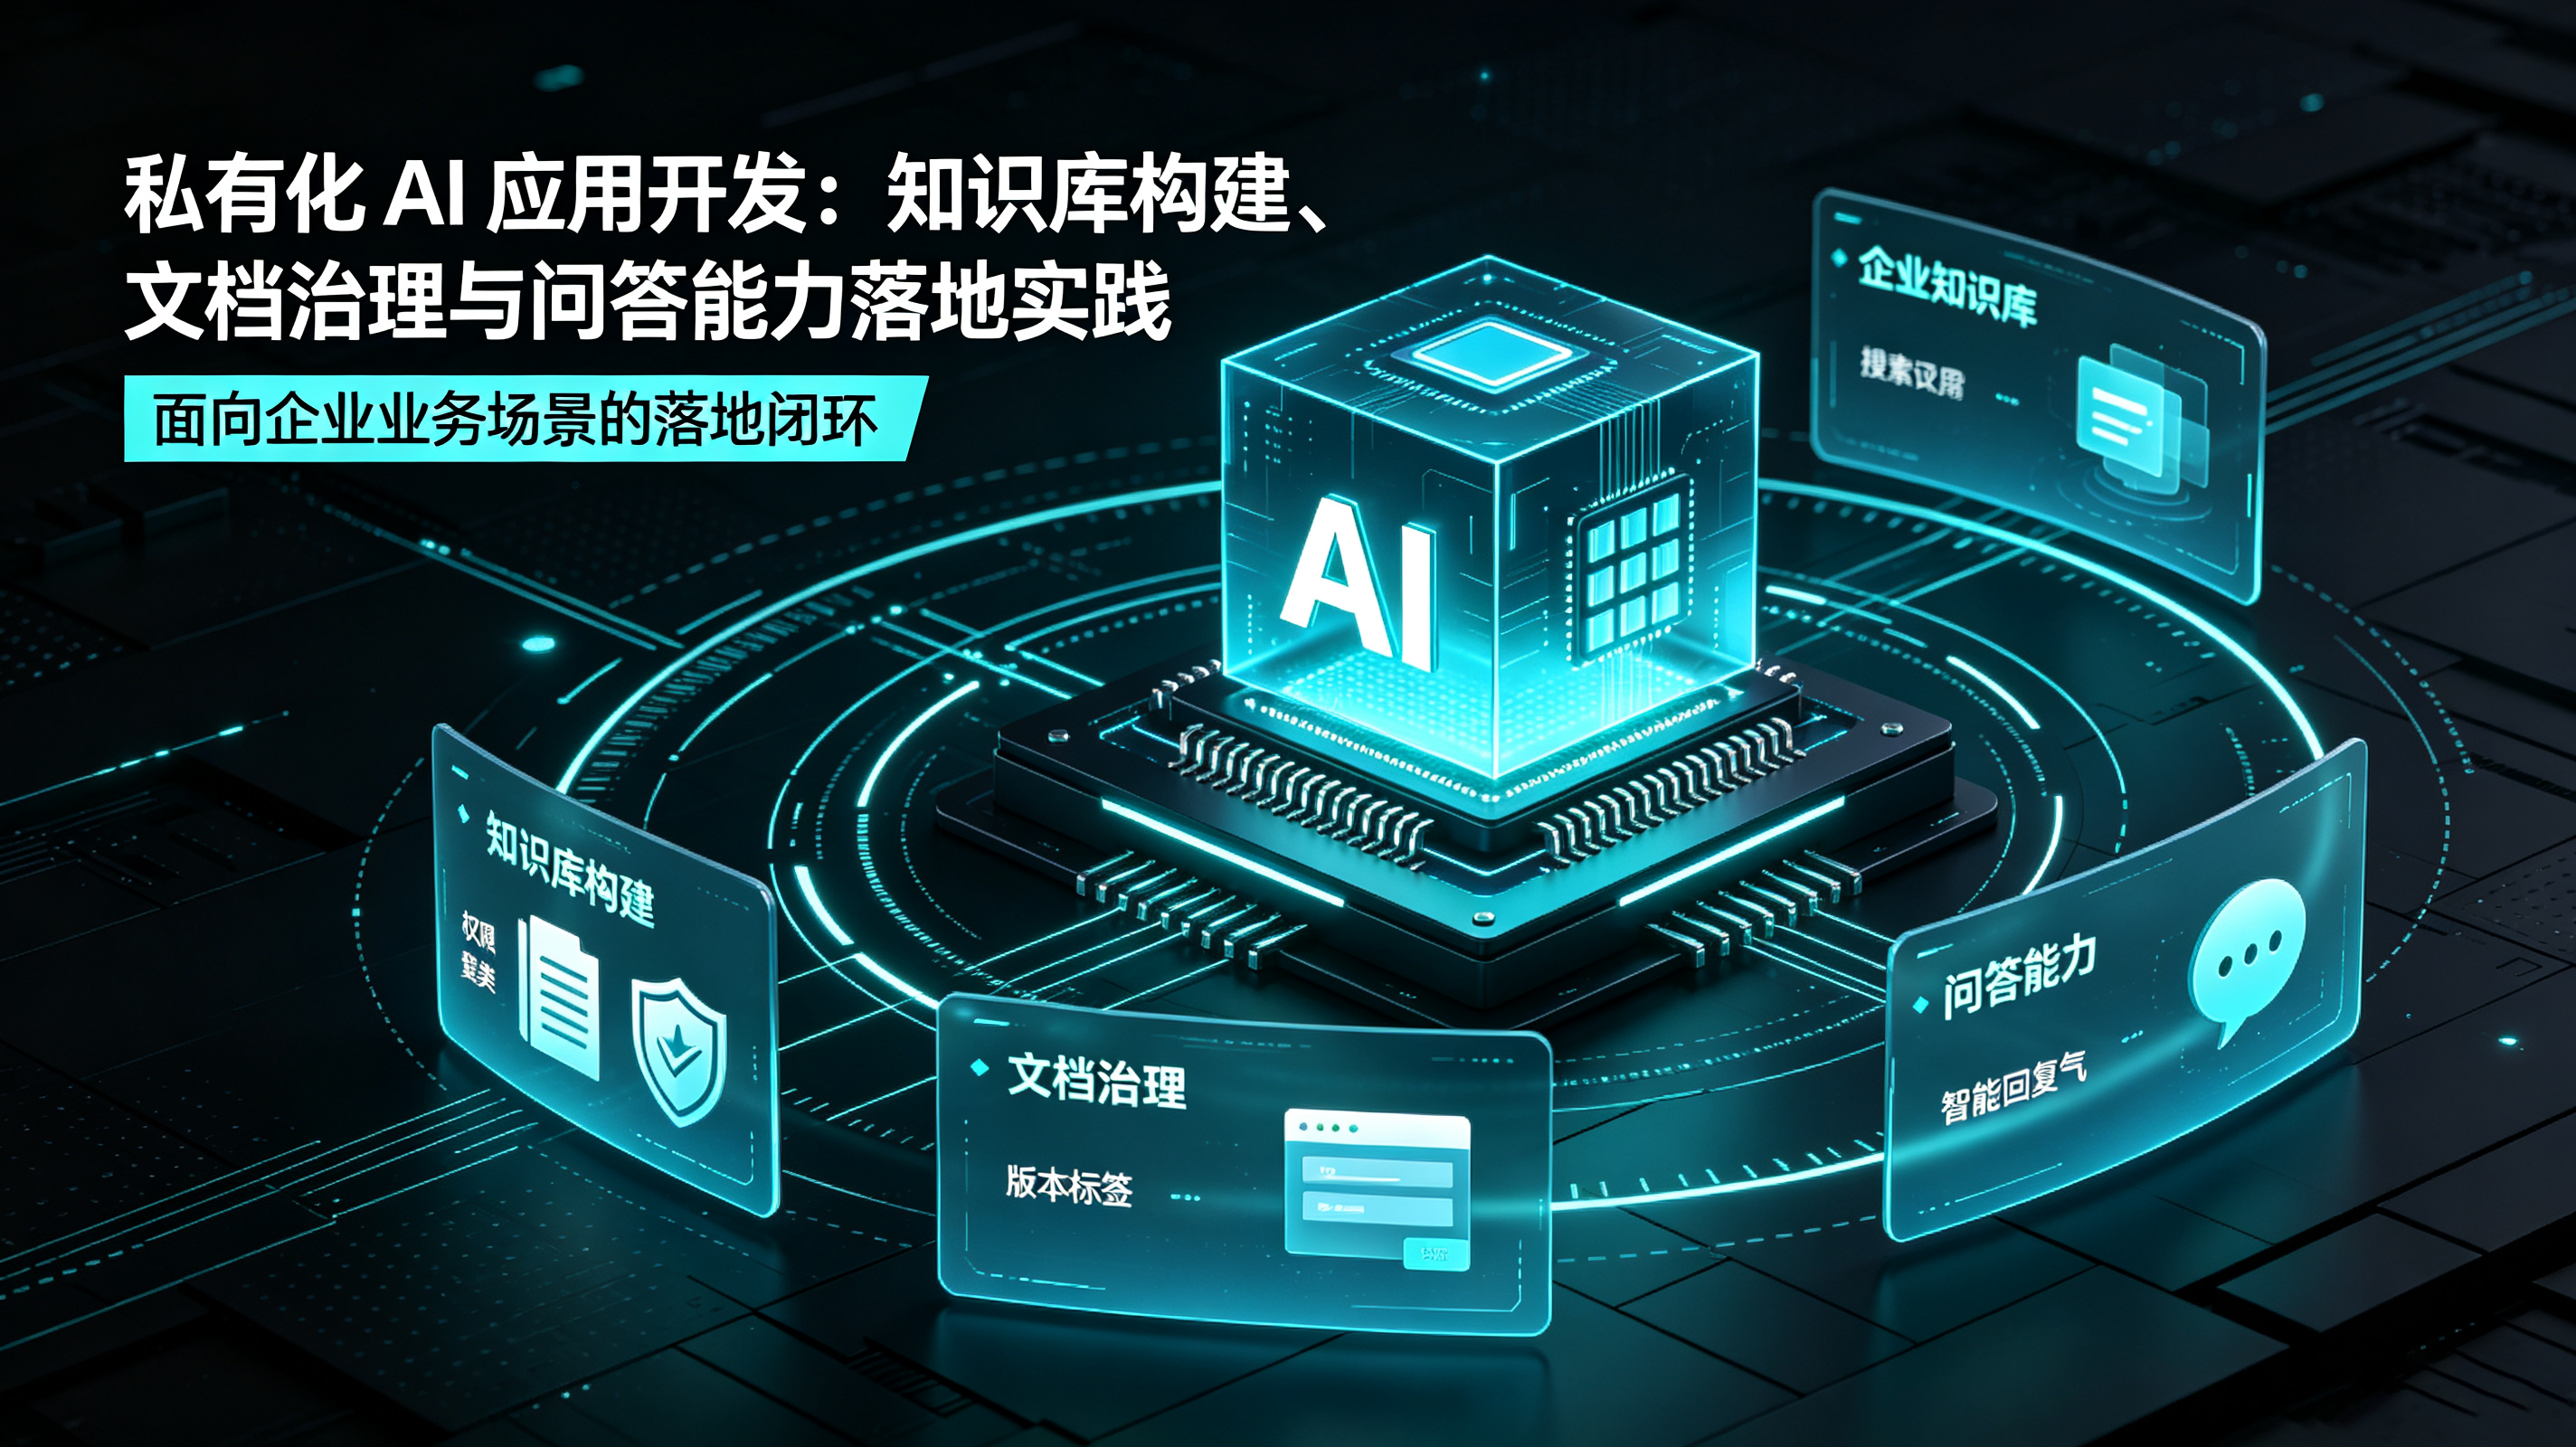
当企业数据涉及客户信息、财务数据、研发文档、合规材料时,公有云 API 往往不是选项。私有化 AI 应用开发成为刚需。但私有化不等于“把模型部署到内网”就结束,真正的挑战在于知识库构建、文档治理和问答能力落地。
知识库构建:从数据源盘点开始。 企业知识散落在 OA、CRM、ERP、邮件、网盘、工单、Wiki、本地文件中。第一步是盘点:哪些系统有知识?哪些高频使用?哪些权限复杂?哪些更新频繁?根据业务价值和使用频率排优先级,而不是一次性全量接入。接入时建立增量同步机制,确保新文档、新版本能自动进入知识库。
文档治理:决定问答质量的地基。 私有化环境中的文档往往格式混乱、版本众多、权限复杂。治理要做四件事:一是解析,处理 PDF、扫描件、表格、多栏排版;二是清洗,去重、去失效、统一术语;三是标注,给每个文档和分块打上部门、版本、生效日期、权限标签;四是生命周期管理,过期文档自动下架或标记。没有文档治理,私有化 AI 只是一个昂贵的搜索框。
问答能力落地:从检索到生成的全链路设计。 一个可用的私有化问答系统,需要处理意图识别、检索召回、重排序、生成控制、引用溯源和拒答。用户问“研发费用加计扣除最新政策”,系统要能识别这是合规问题,检索到最新税务文件和内部解读,按权限过滤,生成带引用的答案。如果找不到可靠来源,应明确说“未找到相关依据”,而不是编造条款。
权限与安全:私有化的核心价值。 知识库必须继承源系统权限,在检索层做过滤。用户只能检索到自己有权查看的内容。同时要记录审计日志:谁问了什么、系统检索了什么、返回了什么。这既是安全要求,也是合规要求。
评测与运营:让系统持续进化。 建一批标准问题集,覆盖高频场景和边界情况。定期测试检索命中率、回答准确率、引用正确率和拒答准确率。上线后收集用户反馈,把错误案例转化为新的测试题和知识补充任务。私有化 AI 不是一次性交付,而是持续运营的系统。
落地路径建议: 先选一个部门、一个场景、一批文档做试点,跑通“文档治理—检索—问答—评测—反馈”闭环。验证效果后,再横向扩展部门,纵向深化能力。不要一开始就追求全公司全覆盖,也不要指望模型自己解决所有问题。私有化 AI 的竞争力,不在模型参数,而在知识库的治理深度和问答链路的工程精度。